IA APLICADA · CASO REAL
Cómo convertimos una necesidad concreta surgida en la Delegación de España ante la OACI en un sistema local de subtítulos y traducción automática del español al inglés, capaz de seguir al orador aunque cambie el guion o improvise.
La inteligencia artificial aplicada no empieza preguntándose qué modelo utilizar. Empieza con un problema. En Montreal surgió una necesidad muy concreta: varias personas debían intervenir en español ante un público que necesitaba seguir sus palabras en inglés. La primera idea parecía sencilla. La solución real, bastante menos.
El problema: traducir en directo sin depender de un guion cerrado
Durante la preparación de un acto en la Delegación de España ante la Organización de Aviación Civil Internacional, OACI, apareció una cuestión práctica: varias de las personas que debían intervenir no hablarían en inglés.
La pregunta fue directa: ¿cómo puede seguir el público sus intervenciones en inglés mientras hablan en español?
La primera solución parecía evidente: traducir previamente los discursos, generar un vídeo con subtítulos en inglés y reproducirlo mientras hablaba cada persona.
El problema es que las personas no hablan como una línea de tiempo. Hacen pausas diferentes, cambian palabras, repiten ideas, eliminan frases, añaden otras e improvisan.
En cuanto el orador se aparta del texto previsto, un vídeo sincronizado deja de ser una solución.
El objetivo
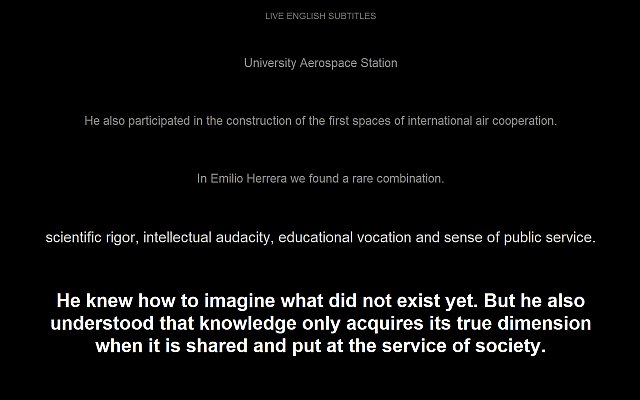
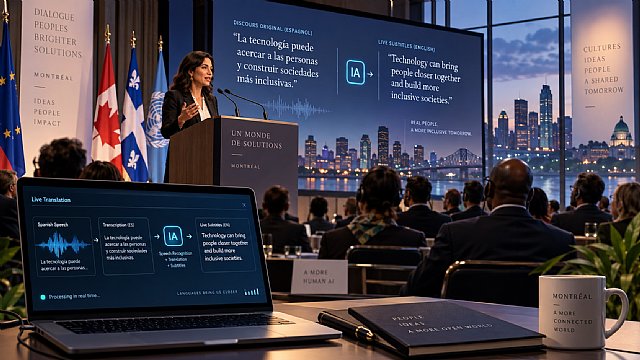
El objetivo pasó a ser otro: crear un sistema capaz de escuchar lo que realmente dice una persona en español, comprenderlo y mostrar una traducción al inglés prácticamente en tiempo real.
Voz en español → transcripción → traducción al inglés → subtítulos en pantalla.
Sobre el papel parece sencillo. Conseguir que funcione de forma suficientemente rápida y fiable para un acto real fue otra historia.
Primera prueba: Whisper traduciendo directamente
La primera aproximación utilizó Whisper para escuchar el micrófono y traducir directamente del español al inglés.
Funcionó desde el principio. Y precisamente ahí apareció uno de los primeros aprendizajes del proyecto: que algo funcione no significa que funcione bien.
En las primeras pruebas aparecieron errores terminológicos importantes. Un globo podía convertirse en globe, una barquilla abierta en open ship y una expresión técnica como escafandra estratonáutica podía terminar traducida de formas completamente incorrectas.
Para una conversación informal estos errores pueden resultar anecdóticos. Para un acto institucional no.
Separar el problema: primero entender, después traducir
La siguiente decisión fue separar dos tareas que inicialmente realizaba el mismo modelo:
Audio → transcripción en español → traducción al inglés.
Esta separación permitía comprobar exactamente dónde se producía cada error.
Y apareció un caso especialmente revelador. En una frase se hablaba de una cantidad de oxígeno insuficiente para sobrevivir. El reconocimiento de voz entendió suficiente.
El traductor hizo correctamente su trabajo: tradujo una frase cuyo significado era justo el contrario de lo que se había dicho.
Una buena traducción de una mala transcripción sigue siendo una mala traducción.
De Whisper Medium a Large V3 Turbo
Para mejorar el reconocimiento se probaron distintos modelos de Whisper. Finalmente, Whisper large-v3-turbo ofreció un equilibrio mucho mejor entre precisión y velocidad.
Con este modelo se corrigieron errores críticos como insuficiente frente a suficiente, además de mejorar el reconocimiento de términos específicos como escafandra estratonáutica.
Otro problema: las frases no duran tres segundos
Una de las primeras versiones procesaba el audio en bloques fijos de tres segundos.
Era rápido, pero las frases quedaban partidas donde decidía el reloj, no donde terminaba de hablar la persona.
La solución fue introducir WebRTC VAD, un sistema de detección de actividad vocal.
A partir de ese momento el programa dejó de preguntarse si habían pasado tres segundos y empezó a preguntarse si la persona seguía hablando o acababa de hacer una pausa.
El sistema dejó de seguir el tiempo y empezó a seguir la voz.
La latencia: escuchar y traducir al mismo tiempo
Una vez resuelto el corte de frases apareció un nuevo problema: mientras la IA traducía una intervención, el orador continuaba hablando.
Si todo se hacía secuencialmente, los fragmentos se acumulaban y los subtítulos terminaban varios segundos por detrás.
La arquitectura se modificó para separar los procesos:
- un proceso escucha continuamente el micrófono;
- otro detecta las pausas y genera bloques de voz;
- otro transcribe y traduce;
- la pantalla recibe los subtítulos terminados.
El micrófono nunca deja de escuchar porque el modelo esté procesando una frase.
Probando modelos de traducción
Durante el desarrollo se probaron distintos motores y modelos: NLLB, Helsinki, MADLAD, Qwen 3B y Qwen 7B.
Algunos eran rápidos pero demasiado literales. Otros ofrecían mejor calidad pero introducían demasiada latencia. Algunos directamente no resultaron adecuados para este caso.
Una de las conclusiones fue especialmente importante: un modelo más grande no implica automáticamente una mejor solución.
El gran cambio: utilizar el discurso previsto como referencia
En un acto institucional existe una ventaja importante: normalmente disponemos previamente del texto que una persona tiene previsto leer.
Eso permite preparar una traducción inglesa correcta y revisada, especialmente en nombres propios, terminología técnica y cifras.
Pero usar el texto preparado introducía un riesgo nuevo: el sistema podía terminar sustituyendo lo realmente dicho por lo que estaba previsto decir.
Durante una prueba, el texto original hablaba de una ascensión hasta 20.000 metros. Deliberadamente dijimos 22.000 metros.
Una de las primeras versiones detectó que la frase se parecía muchísimo al guion y mostró la traducción preparada: 20,000 metres.
Eso era inaceptable.
El guion ayuda. La voz manda.
SpeechBridge: traducción híbrida
La solución evolucionó hasta un sistema híbrido con tres comportamientos.
DIRECTO
Si lo pronunciado coincide con el discurso previsto, se utiliza directamente la traducción previamente revisada.
ADAPTADO
Si la frase se parece al guion pero cambia una cifra, una palabra, un dato o una parte del contenido, la IA utiliza la traducción revisada como referencia pero adapta el resultado a lo realmente pronunciado.
LIBRE
Si el orador improvisa o introduce contenido nuevo, el sistema traduce ese fragmento en tiempo real.
Las pausas del orador tampoco coinciden con el guion
Tener un discurso preparado no significa que las pausas reales coincidan con los puntos y comas del documento.
Una persona puede juntar dos frases o dividir una frase en varios bloques.
Por eso el guion dejó de almacenarse como grandes párrafos y pasó a dividirse en pequeños bloques de subtítulos.
El sistema compara cada intervención tanto con un bloque como con dos bloques consecutivos. Esto permite tolerar diferencias entre el texto escrito y la forma real de hablar.
Probando qué ocurre cuando el orador cambia completamente el discurso
Una de las pruebas finales fue precisamente dejar de seguir el guion.
Se habló de la España de los años treinta, de las capas altas de la atmósfera, de observaciones científicas, de instrumentos de vuelo, de Montreal y de la colaboración entre España y la OACI.
Buena parte de este contenido no estaba en el texto de referencia.
El sistema continuó funcionando: reconoció el español, tradujo los nuevos fragmentos y utilizó correctamente la terminología conocida cuando aparecía.
Todo funciona en local
Otro de los objetivos del proyecto era reducir la dependencia de servicios externos.
En la configuración actual:
- el audio se captura localmente;
- Whisper se ejecuta en la GPU del ordenador;
- Qwen realiza la traducción localmente;
- el guion de referencia se almacena en un fichero JSON;
- la pantalla de subtítulos funciona sin depender de Internet.
Para entornos institucionales, culturales o expositivos, esta autonomía puede ser especialmente útil.
El resultado
El sistema actual es capaz de:
- escuchar una intervención en español;
- detectar automáticamente las pausas;
- transcribir con Whisper large-v3-turbo;
- comparar el contenido con un discurso previamente preparado;
- utilizar traducciones revisadas cuando corresponda;
- adaptarlas si el orador modifica el discurso;
- traducir libremente las improvisaciones;
- mostrar subtítulos en inglés prácticamente en tiempo real;
- guardar transcripción, traducción y registros de diagnóstico.
IA aplicada
Lo más interesante de este proyecto no es únicamente el programa final. Es el proceso.
No empezamos preguntándonos qué podíamos hacer con Whisper, Qwen o un modelo determinado.
La pregunta fue:
Tenemos este problema. ¿Cómo podemos resolverlo?
A partir de ahí llegaron las pruebas, los errores, las comparaciones de modelos, las decisiones de arquitectura y las mejoras sucesivas.
Eso es, para mí, IA aplicada: no utilizar inteligencia artificial porque exista, sino utilizarla cuando ayuda a resolver un problema concreto.
Y en esta ocasión el problema apareció a varios miles de kilómetros de casa, en Montreal.
La tecnología viaja bien. Los problemas reales también.
Y algunas soluciones empiezan simplemente con una pregunta:
¿Qué podemos hacer?